剧本策划助手▸
 Ai应用
 Ai资讯
 小说剧本转漫剧
 做PPT写文案
 Seko漫剧生成
中国哲学书电子化计划
中国哲学书电子化计划简介
中国哲学书电子化计划是什么
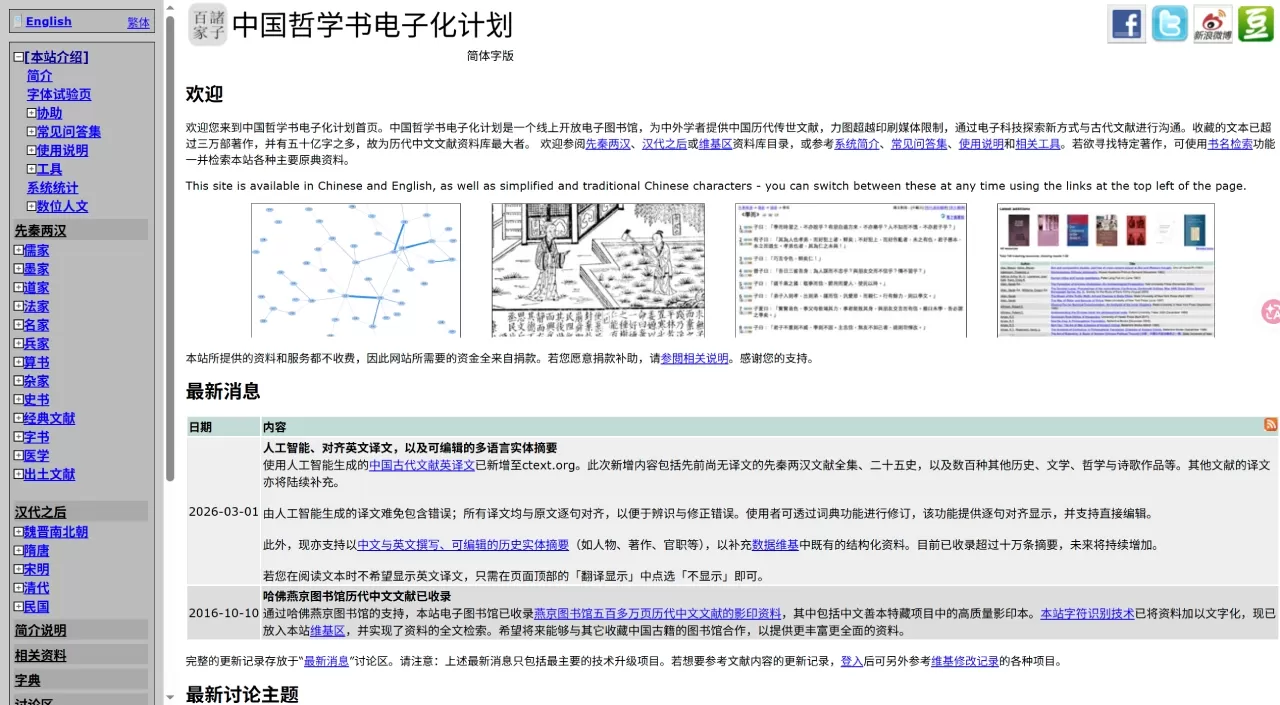
中国哲学书电子化计划,简称 CTP,是一个线上开放的古籍图书馆和全文检索系统,由英国学者德龙2005 年发起,从"一人一服务器"做到今天,已经稳定运营了二十年。
中国哲学书电子化计划目前收录超过 3 万部著作、50 亿字数字化文本,包含 3600 万页原始文献,还有哈佛燕京图书馆 500 多万页影印本对照。内容分先秦两汉、汉代之后和维基区三块,覆盖经史子集、字书、医学、出土文献等。支持繁简切换和中英双语,生僻字也能正常显示。
中国哲学书电子化计划使用完全免费,不需要注册。机构可以订阅获取 JSON API 和 Python 模块,这是站点唯一的收入来源,官方明确禁止网页抓取。
核心功能
原典资料库:以先秦两汉为核心,历代持续扩充,文本按篇章节句分层,每段都能独立定位引用
全文检索和书名检索:支持全库搜、限定朝代或单书搜,还能用布尔运算和邻近词共现做高级查询
内置字典:整合 Unicode 数据、原典语料和自研字典,点击任意字就能看释义、读音、异体字和文献出处
词语分析表:对整段文字逐字给出释义和读音,自动标注通假字和特殊读法
相似段落比对:自动找出同一句话或典故在不同典籍里的表述,并排展示,方便看引用和改写
影印本对照:数字化文本和哈佛燕京图书馆扫描件按章卷互链,可以逐句核对底本
元数据与索引:提供引得、索引数据和 RDF 格式的历史数据,方便做知识图谱
众包协作:注册后可以在维基区录入和校订文本,社区修订是持续纠错的主要来源
为什么选择中国哲学书电子化计划
体量大,先秦两汉基本收全,开源古籍库里覆盖密度数一数二
完全免费开放,不用注册、没并发限制,高校图书馆普遍推荐
以原文为中心,底本来源广,查原文比商业库更快更灵活
不只是书库,字典、语义链接、词语分析、相似段落、影印对照串成一条完整的研究流水线
段落级固定链接加上影印本对照,引文可复查可追溯
学术公信力强,被全球多所高校图书馆正式收录
公益运营二十年,没有商业库到期停服的风险
中国哲学书电子化计划界面停留在 2005 年代,移动端体验一般,部分古籍缺少标点和注释,AI 译文质量不稳定,正式学术引用还是要对照权威整理本。
适用场景与群体
文史哲研究者和博士生:做概念史、词汇史取证,异文比勘,引文溯源,出土文献对读
高校师生:备课查原文上下文,布置文献检索训练,古代汉语课逐字释义
数字人文和 NLP 研究者:构建古汉语语料库,训练模型,通过 API 批量取数做文本挖掘
翻译者和汉学家:中英逐段对照,核查字义和读法
出版编辑和古籍整理者:初校底本,核对典故出处
内容创作者和自媒体:查名句原始出处和完整上下文,避免搬运错字
国学爱好者:免费读原文加白话或英译对照,零成本入门
图书馆和机构:作为免费基础资源采购,或为研究团队订阅 API
中国哲学书电子化计划用法
直接把记忆中的句子丢进全库检索,命中后读完整上下文,理解更准确
用书名检索找本子,再进书内检索,避免同名异本混淆
阅读时点任意字查字典,需要逐字解析就开词语分析表
对某段启用相似段落,看同一表述在其他书里怎么被引用和改写
对转录存疑的地方切到扫描件逐句核对,判断是底本如此还是转录错误
用布尔条件和邻近词共现定位思想关联,按书或朝代分组比较
把目标典籍导出纯文本,配合 Python 做词频、共现、向量分析;批量取数走机构订阅 API,别爬站
开启中英对照,逐句比对原文和英译,兼顾语言学习和翻译参考
注册后在维基区录入缺书、校对错字,把个人校读成果沉淀进公共库
引用时标注书名、版本、篇章和站内链接,正式发表前对照权威整理本
常见问题
问:需要付费或注册吗?
阅读检索全部免费,无需注册。只有参与录入校对需要账号,批量数据和 API 走机构订阅。
问:订阅是干什么的?
面向高校和研究机构,提供 JSON API 和 Python 模块,可获取比网页抓取更多更准确的数据。订阅是站点唯一收入来源,机构侧成本不高,通常可用图书馆预算。
问:可以直接爬站取数据吗?
不可以。官方禁止抓取,反爬机制会返回故意损坏的数据,爬取结果会污染研究结论。研究型需求走机构订阅 API。
问:文本准确吗?能直接引用吗?
可靠性在开源库里属第一梯队,但仍可能有讹误。正式学术引用建议以中华书局点校本等权威整理本为准,并注明所用版本。
问:有标点、注释、译文吗?
部分典籍有现代汉语或英文翻译,部分提供读音和异体字对照,但并非全部都有,缺注时可用内置字典辅助。
问:AI 翻译可靠吗?
2026 年新增了不少 AI 生成的逐句英译,便利但质量参差,学术用途请以人工译本和整理本为准。
问:收录下限到什么时候?
先秦两汉最完备,汉代之后按朝代持续扩充,但清人注疏类整理本不如商业整理本库齐全。
类似竞品对比
| 平台 | 运营方 | 是否免费 | 最新公开规模 | 文本性质 | 特色能力 | 更适合谁 |
|---|---|---|---|---|---|---|
| 中国哲学书电子化计划 | 德龙个人发起 + 众包社区,公益运营 | 免费阅读检索;机构订阅取 API | 超 3 万部、50 亿字;3600 万页原始文献;哈佛燕京 500 万页影印 | 原典原文为中心,多底本 | 全文/高级检索、内置字典+语义链接+词语分析表、相似段落比对、影印对照、中英对照、API | 需要查得全、查得准、能挖掘的研究者、数字人文团队、翻译者 |
| 识典古籍 | 北京大学 × 字节跳动,公益项目 | 免费、无需登录 | 截至 2026 年 1 月上线 4.7 万部 | 原文为主,AI 整理 | OCR、自动标点、命名实体识别、公众校对、AI 助手、实体关系图 | 大众读者、需要 AI 辅助通读和移动阅读的用户 |
| 中华经典古籍库 | 中华书局 / 古联数字传媒 | 商业,需机构订阅 | 截至 2025 年 12 月十三期,10900 余种、约 30 亿字 | 整理本为中心,含注释校勘 | 文本与图像逐页对照、横竖版切换、自动生成引用格式、专有字库 | 需要权威点校本和规范引注的正式研究 |
| 维基文库 | 维基媒体社区 | 免费、开放 | 众包规模持续增长 | 众包原文 | 多语种、可下载、开放授权 | 需要自由授权文本和批量下载者 |
| 国学大师 | 民间站点 | 免费为主 | 集成型 | 原文 + 工具聚合 | 一字并联多部字典、字形演变、书法查询 | 训诂、字义与字形研究者 |
| 爱如生基本古籍库 / 国家图书馆古籍资源库 / 书格 | 商业数据库 / 国家图书馆 / 公益站 | 前者订阅,后两者免费 | 以影像与专题库见长 | 影像 + 全文 | 全文检索、善本高清影像 | 需要底本影像的版本学研究者 |