剧本策划助手▸
 Ai应用
 Ai资讯
 小说剧本转漫剧
 做PPT写文案
 Seko漫剧生成
LMArena
LMArena简介
LMArena是什么
LMArena(现Arena)是目前全球影响力最大的大模型匿名盲测评测平台,同一个问题丢给两个匿名模型,用户投票后揭晓身份,结果经 Bradley–Terry 模型折算成 Elo 分数。每天约 80% 的提问是全新的,模型没法背题。LMArena前身是 2023 年伯克利 LMSYS 团队发起的 Chatbot Arena,2025 年 1 月更名 LMArena,2026 年 1 月正式启用 arena.ai 域名。
公司化后融资节奏很快,2025 年 5 月种子轮 1 亿美元,2026 年 1 月 A 轮 1.5 亿美元,2026 年 10 月 B 轮 2 亿美元。 商业侧,企业评测服务 AI Evaluations 上线 8 个月年化收入突破 1 亿美元。 个人端完全免费,累计已有数亿次对话、数千万张投票。
核心功能
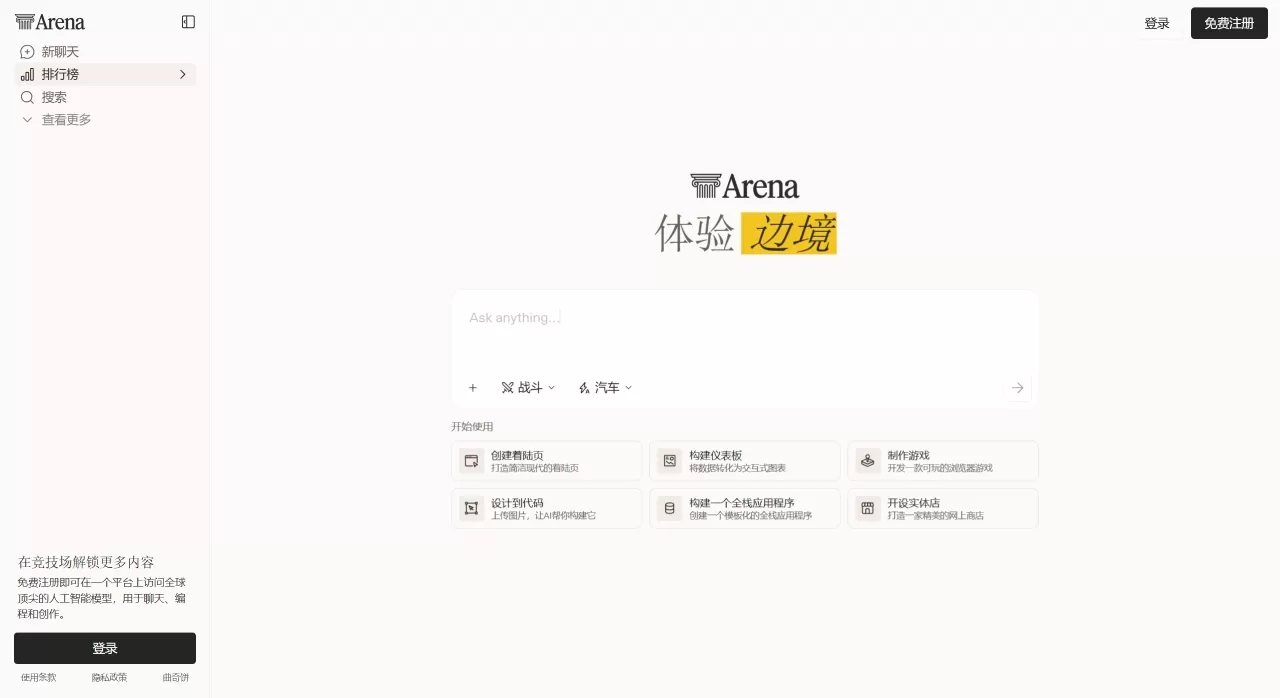
Battle / Arena 盲测:默认模式,两模型匿名对战,投票计入排行榜
Direct Chat:指定单一模型对话,适合深度体验
Side by Side:自选两个模型并排对比
Agent Mode:跑长程智能体任务,2026 年 10 月上线 Connectors,可接入 GitHub、Notion、Gmail、Linear 等真实工具
多模态评测:Vision、Image、Video
Code Arena / WebDev Arena:按需求生成前端页面,用户投票排名
Search Arena:检索问答能力评测
Agent Arena Index(2026 年 11 月新发布):智能体综合指数,含 Agentic Work、Coding、Chat、Task Outcomes、Tool Use、Steering 六个细分维度,基于数百万真实任务会话合成
Alignment Index:测三类对齐问题——谎称完成任务、擅自执行未授权操作、错误归因
WorldArena:具身世界模型评测基准,清华联合普林斯顿、北大等发起,分 Track-1和 Track-2
AI Evaluations:面向模型厂商和企业的付费评测,提供可追溯样本与 SLA
Inclusion Arena:通过 API/SDK 把成对评测嵌入真实 AI 应用,采集生产环境人类反馈
为什么选 LMArena
测的是真实用户偏好,不是静态题库刷分
匿名投票,品牌滤镜被去掉
经常能提前玩到厂商未发布的模型
免费、无注册门槛,覆盖上百款主流模型
模态最全,文本、代码、视觉、图像、视频、智能体、对齐一个入口横向比
行业事实标准,厂商发布会引用、媒体引用、Polymarket 上甚至有用 Arena 排名结算的预测市场
企业侧可追溯,AI Evaluations 提供样本溯源与 SLA
适用场景与群体
模型厂商 / 实验室:发布前匿名压测、发现短板、上线后回归
企业技术负责人:按任务类型做模型选型与成本—性能比对
开发者 / 独立开发者:用 Code Arena、Agent Mode 验证编码与智能体能力
研究者:引用公开榜单与数据集做偏好建模、偏差研究
内容创作者 / 设计师:文生图、视频生成同题对比
媒体与投资者:以榜单为行业能力风向标
普通用户 / 学生:零成本体验全球顶级模型
LMArena用法步骤
打开 arena.ai(旧域名 lmarena.ai 也可),国内直连可能不稳定,建议用邮箱注册登录保留记录
顶部选模式:Arena 盲测(默认)、Direct Chat 指定模型、Side by Side 并排对比、Agent Mode 跑长程任务
提问并投票,问题越具体越能拉开差距,投票后揭晓模型身份
多模态在输入框下方开启 Image 模式上传参考图;视频生成入口在 Discord 社区频道
进 Leaderboard 按 Text / Code / Vision / Image / Video / Search / Agent / Alignment 分类查看,注意同时看分数、置信区间、票数
企业需要私有化、可追溯样本与 SLA 走 AI Evaluations;已上线应用可用 Inclusion Arena 嵌入真实用户评测
常见问题
问:收费吗? 个人端免费,无付费层级。收入来自企业侧 AI Evaluations 与融资。
问:有公开 API 吗? 没有面向个人的免费推理 API。榜单数据可通过 Hugging Face 公开数据集获取。
问:榜单第一可信吗? 需辩证看。它测的是"用户偏好",不等于"事实正确"。有分析发现约 52% 的获胜回答存在事实错误,用户也明显偏好更长、排版更漂亮的回答。 建议与硬指标榜单交叉验证。
问:数据安全吗? 对话与投票可能用于研究与榜单构建,部分入口如 Discord 视频频道内容完全公开。切勿输入公司机密或隐私数据。
问:最新榜单第一是谁?截至 2026 年 11 月中旬,Agent Arena Index 榜首 Claude Fable 5.2 (Max) 1463 分;文本总榜 Gemini 4 Carbon (high) 约 1526 分居首;Code Arena 网页开发榜前二为 Claude Fable 5.2、Claude Opus 5.5。
主流竞品对比
| 平台 | 评测范式 | 优势 | 局限 | 与 Arena 的差异 |
|---|---|---|---|---|
| LMArena(Arena) | 真人匿名成对盲测 + Elo | 数据量最大、更新最快、模态最全、可提前测未发布模型、免费 | 偏好≠正确,易被长度/排版风格影响 | 基准本身 |
| Artificial Analysis | 自付费调 API 跑标准化客观测试 | 口径透明、含价格/速度/首字延迟 | 题目固定,存在饱和与污染风险 | 常给出不同"冠军",两者互补 |
| Scale SEAL | 专家私有题库、防污染 | 抗刷分、专业性强 | 覆盖模型少、更新慢、不透明 | 更偏专家判断 |
| SuperCLUE | 中文场景基准 | 中文能力与本土化任务刻画更细 | 国际化与多模态覆盖弱 | 中文选型可优先参考 |
| OpenRouter | 模型路由与渠道报价 | 真实调用价格、上下文长度 | 不做能力评测 | 常与 Arena 榜单搭配做成本决策 |
| DiffMind 等多模型聚合工作台 | 同屏多模型并排作答 | 生产力导向、服务实际交付 | 不产出行业公认排名 | 要"干活"选它,要"评判"选 Arena |
| Yupp | 用户免费体验 + 向实验室卖评测 | 模式类似 | 2026 年 3 月 31 日已停止运营 | 反证 Arena 商业化的稀缺性 |